Domain mkmm.de kaufen?
Wir ziehen mit dem Projekt
mkmm.de um.
Sind Sie am Kauf der Domain
mkmm.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain mkmm.de kaufen?
Wie nutzt man Windows Speech Recognition richtig in Visual Basic?
Um Windows Speech Recognition in Visual Basic zu nutzen, müssen Sie zunächst sicherstellen, dass Sie die entsprechenden Verweise auf die Speech API in Ihrem Projekt hinzugefügt haben. Dann können Sie die SpeechRecognitionEngine-Klasse verwenden, um Spracheingaben zu erkennen und zu verarbeiten. Sie können Ereignisse wie SpeechRecognized und SpeechRecognitionRejected abonnieren, um auf erkannte oder abgelehnte Spracheingaben zu reagieren. Schließlich können Sie die RecognizeAsync-Methode aufrufen, um die Spracherkennung zu starten und auf Benutzereingaben zu warten. **
Wie funktioniert die Text-to-Speech-Funktion auf TikTok?
Die Text-to-Speech-Funktion auf TikTok verwendet eine Spracherkennungssoftware, um den eingegebenen Text in Sprache umzuwandeln. Die Software analysiert den Text und generiert dann eine Sprachausgabe, die im Video abgespielt wird. Die Benutzer können aus verschiedenen Sprachoptionen wählen und die Geschwindigkeit der Sprachausgabe anpassen. **
Ähnliche Suchbegriffe für Speech Recognition SR
Top-Angebote
Produkte zum Begriff Speech Recognition SR:
-
Waves Dugan SpeechWaves Dugan Speech (ESD); Automix-Plugin; Automix-Anwendung für Waves SuperRack und eMotion LV1 Mixer, entwickelt in Zusammenarbeit mit Dan Dugan; mischt bis zu 64 Live-Mikrofonkanäle gleichzeitig automatisch und in Echtzeit; kein manuelles Regeln notwendig; sichert konstanten Gesamtpegel; perfekt abgestimmte Crossfades; nahtlose Integration in eMotion LV1 Mixer sowie SuperRack; unterstützte Formate: Waves SuperRack, eMotion LV1 Mixer589,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
the t.bone Speech 100 Mthe t.bone Speech 100 M, Steuerzentrale für digitales Konferenzsystem, 2 Gruppen für jeweils bis zu 16 Sprechstellen, Feedbackunterdrückung, USB Aufnahme und Playback (*.mp3, Datenträger bis 32 GB), 4 Diskussionsmodi (3, 6, 9 oder alle Mikrofone können gleichzeitig aktiviert werden), Abstimmungs-Modus, 2x Stereo Rec Out (Cinch), 1x Stereo Out für Soundsystem (Cinch), 1x Stereo In (Cinch), 1x Mic In (XLR mit Phantomspeisung), 1x LAN, Abmessungen: 19" / 2HE, 32cm Einbautiefe, Gewicht 5,5 kg; passendes Case: Art. 496024 (nicht im Lieferumfang enthalten); passender Booster für mehr als 16 Sprechstellen je Linie: Art. 498125 (nicht im Lieferumfang enthalten)469,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Was kann man tun, wenn das Google Speech Service Update hängt?
Wenn das Google Speech Service Update hängt, gibt es einige Schritte, die du ausprobieren kannst. Zuerst solltest du sicherstellen, dass du über eine stabile Internetverbindung verfügst. Dann kannst du versuchen, das Update manuell neu zu starten oder das Gerät neu zu starten. Wenn das Problem weiterhin besteht, kannst du dich an den Google-Support wenden, um weitere Hilfe zu erhalten. **
-
Was ist Hate Speech?
Hate Speech bezieht sich auf Äußerungen, die Hass, Diskriminierung oder Gewalt gegen bestimmte Personen oder Gruppen aufgrund ihrer Rasse, Religion, sexuellen Orientierung, Geschlecht oder anderer Merkmale fördern oder unterstützen. Diese Äußerungen können sowohl online als auch offline stattfinden und haben das Potenzial, Schaden anzurichten und die Opfer zu verletzen. Hate Speech wird oft als Verstoß gegen die Meinungsfreiheit betrachtet, aber es gibt rechtliche Grenzen, die den Schutz vor Hass und Diskriminierung gewährleisten sollen. **
-
Was bedeutet Hate Speech?
Hate Speech bezeichnet beleidigende, diskriminierende oder gewalttätige Äußerungen, die aufgrund von Rasse, Religion, Geschlecht, sexueller Orientierung oder anderen persönlichen Merkmalen Hass und Feindseligkeit fördern. Es handelt sich um eine Form der verbalen Gewalt, die Menschen verletzen und ihre Rechte verletzen kann. Hate Speech ist in vielen Ländern gesetzlich verboten und wird von Online-Plattformen und sozialen Medien zunehmend bekämpft. **
-
Was ist der Unterschied zwischen einem SR- und einem RS-Glied und welche Funktion hat ein SR-Glied anhand seiner Eingänge?
Ein SR-Glied (Set-Reset-Glied) und ein RS-Glied (Reset-Set-Glied) sind zwei verschiedene Arten von Flip-Flops, die in der digitalen Schaltungstechnik verwendet werden. Der Hauptunterschied zwischen ihnen liegt in der Reihenfolge, in der die Eingangssignale angewendet werden, um den Zustand des Flip-Flops zu ändern. Ein SR-Glied hat zwei Eingänge: den Set-Eingang (S) und den Reset-Eingang (R). Je nachdem, welche Eingangssignale anliegen, kann das SR-Glied in einen von vier möglichen Zuständen wechseln: Set (Q=1, Q'=0), Reset (Q=0, Q'=1), Toggle (Q=1, Q'=1) oder Hold (Q=0, Q'=0). Die genaue **


Wie funktioniert Speech to Text?
Speech to Text funktioniert, indem gesprochene Wörter mithilfe von Spracherkennungssoftware in Text umgewandelt werden. Dabei werden die Audiosignale des gesprochenen Textes analysiert und in Text umgewandelt. Die Software erkennt dabei Sprachmuster, Wörter und Sätze, um sie korrekt zu transkribieren. Dieser Prozess basiert auf komplexen Algorithmen und künstlicher Intelligenz, die kontinuierlich verbessert werden, um die Genauigkeit der Umwandlung zu erhöhen. Das Ergebnis ist ein geschriebener Text, der die gesprochene Sprache möglichst genau wiedergibt. **
Wie verbessert Voice Recognition die Benutzererfahrung in der Technologie? Welche potenziellen Anwendungen hat Voice Recognition im Alltag?
Voice Recognition verbessert die Benutzererfahrung, indem sie die Interaktion mit Technologie vereinfacht und beschleunigt. Potenzielle Anwendungen im Alltag sind Sprachsteuerung von Smart Home-Geräten, Navigationssystemen im Auto und virtuellen Assistenten wie Siri oder Alexa. Voice Recognition kann auch in der Medizin zur Diktation von Berichten oder in der Bildung zur Verbesserung des Lernprozesses eingesetzt werden. **
Top-Angebote
Produkte zum Begriff Speech Recognition SR:
-
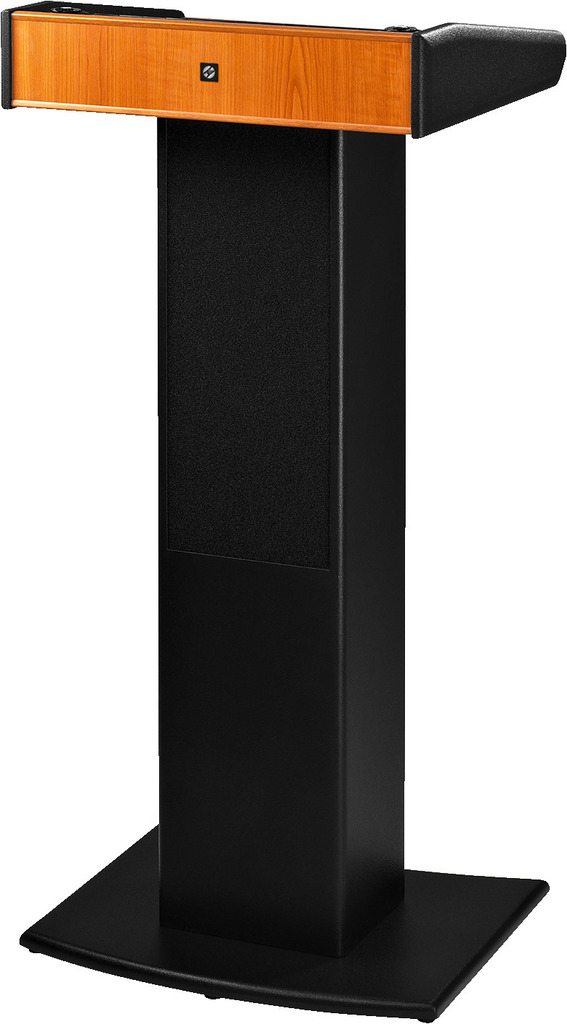
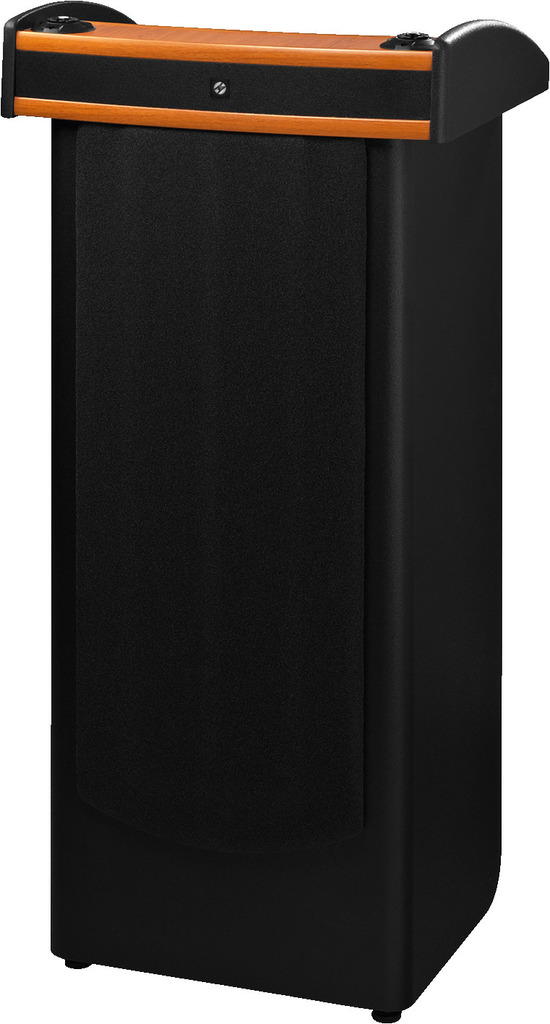
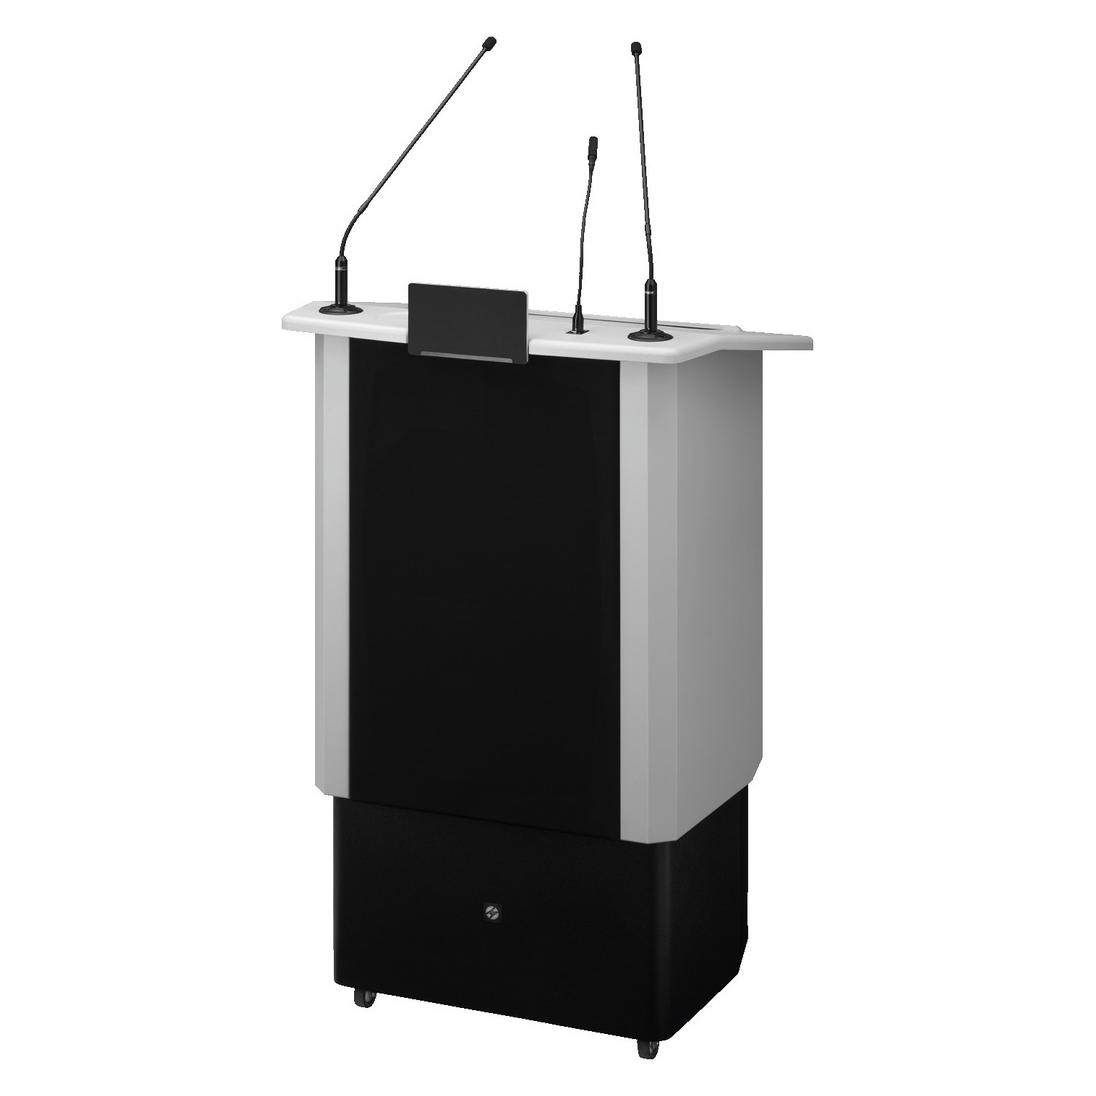
MONACOR SPEECH-104DSPEECH-104D, Eine innovative Qualit�tsl�sung f�r die hochwertige Sprach- und Musikbeschallung: Das SPEECH-104D-Aktiv-Rednerpult von MONACOR verbindet Klangqualit�t, Lautst�rkef�higkeit und Komfort in einer perfekten Weise. Akkubetrieben und damit komplett ortsunabh�ngig macht allein das SPEECH-104D aus jeder zu beschallenden Fl�che ein Auditorium. Es passt sich aber selbstverst�ndlich auch in jede gegebene Umgebung ein, wo eine zeitlich begrenzte oder auch permanente Redestelle ben�tigt wird. Die integrierte Verst�rker- und Lautsprechertechnik erlaubt dabei nicht nur die Sprachwiedergabe, sondern macht auch Musik und zum Beispiel Film- und Pr�sentationsvertonungen denkbar gut und einfach. Ein Schwanenhalsmikrofon einstecken und/oder eine Signalquelle anschlie�en - einschalten - fertig.1648,49 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Waves Dugan SpeechWaves Dugan Speech (ESD); Automix-Plugin; Automix-Anwendung für Waves SuperRack und eMotion LV1 Mixer, entwickelt in Zusammenarbeit mit Dan Dugan; mischt bis zu 64 Live-Mikrofonkanäle gleichzeitig automatisch und in Echtzeit; kein manuelles Regeln notwendig; sichert konstanten Gesamtpegel; perfekt abgestimmte Crossfades; nahtlose Integration in eMotion LV1 Mixer sowie SuperRack; unterstützte Formate: Waves SuperRack, eMotion LV1 Mixer589,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie nutzt man Windows Speech Recognition richtig in Visual Basic?
Um Windows Speech Recognition in Visual Basic zu nutzen, müssen Sie zunächst sicherstellen, dass Sie die entsprechenden Verweise auf die Speech API in Ihrem Projekt hinzugefügt haben. Dann können Sie die SpeechRecognitionEngine-Klasse verwenden, um Spracheingaben zu erkennen und zu verarbeiten. Sie können Ereignisse wie SpeechRecognized und SpeechRecognitionRejected abonnieren, um auf erkannte oder abgelehnte Spracheingaben zu reagieren. Schließlich können Sie die RecognizeAsync-Methode aufrufen, um die Spracherkennung zu starten und auf Benutzereingaben zu warten. **
-
Wie funktioniert die Text-to-Speech-Funktion auf TikTok?
Die Text-to-Speech-Funktion auf TikTok verwendet eine Spracherkennungssoftware, um den eingegebenen Text in Sprache umzuwandeln. Die Software analysiert den Text und generiert dann eine Sprachausgabe, die im Video abgespielt wird. Die Benutzer können aus verschiedenen Sprachoptionen wählen und die Geschwindigkeit der Sprachausgabe anpassen. **
-
Was kann man tun, wenn das Google Speech Service Update hängt?
Wenn das Google Speech Service Update hängt, gibt es einige Schritte, die du ausprobieren kannst. Zuerst solltest du sicherstellen, dass du über eine stabile Internetverbindung verfügst. Dann kannst du versuchen, das Update manuell neu zu starten oder das Gerät neu zu starten. Wenn das Problem weiterhin besteht, kannst du dich an den Google-Support wenden, um weitere Hilfe zu erhalten. **
-
Was ist Hate Speech?
Hate Speech bezieht sich auf Äußerungen, die Hass, Diskriminierung oder Gewalt gegen bestimmte Personen oder Gruppen aufgrund ihrer Rasse, Religion, sexuellen Orientierung, Geschlecht oder anderer Merkmale fördern oder unterstützen. Diese Äußerungen können sowohl online als auch offline stattfinden und haben das Potenzial, Schaden anzurichten und die Opfer zu verletzen. Hate Speech wird oft als Verstoß gegen die Meinungsfreiheit betrachtet, aber es gibt rechtliche Grenzen, die den Schutz vor Hass und Diskriminierung gewährleisten sollen. **
Ähnliche Suchbegriffe für Speech Recognition SR
-
the t.bone Speech 100 Mthe t.bone Speech 100 M, Steuerzentrale für digitales Konferenzsystem, 2 Gruppen für jeweils bis zu 16 Sprechstellen, Feedbackunterdrückung, USB Aufnahme und Playback (*.mp3, Datenträger bis 32 GB), 4 Diskussionsmodi (3, 6, 9 oder alle Mikrofone können gleichzeitig aktiviert werden), Abstimmungs-Modus, 2x Stereo Rec Out (Cinch), 1x Stereo Out für Soundsystem (Cinch), 1x Stereo In (Cinch), 1x Mic In (XLR mit Phantomspeisung), 1x LAN, Abmessungen: 19" / 2HE, 32cm Einbautiefe, Gewicht 5,5 kg; passendes Case: Art. 496024 (nicht im Lieferumfang enthalten); passender Booster für mehr als 16 Sprechstellen je Linie: Art. 498125 (nicht im Lieferumfang enthalten)469,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
the t.bone Speech 100 Cthe t.bone Speech 100 C, Chairman, Präsidentensprechstelle für digitales Konferenzsystem, Kondensatormikrofon, LCD-Display, Tasten für Abstimmung, eingebauter Lautsprecher mit Lautstärkeregelung, Kopfhöreranschluss, Prioritätssteuerung für Präsidentensprechstelle, 2x LAN (In/Link), Mikrofon-Schwanenhalslänge ca. 40 cm, 1x 2m Netzwerkkabel im Lieferumfang enthalten, Abmessungen: 169 x 46 x 175 mm (B x H x T), Gewicht 0,7 kg198,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
the t.bone Speech 100 Bthe t.bone Speech 100 B - Netzteilerweiterung (Booster) für die Sprechstellen 100 C und 100 D des digitalen Konferenzsystem Speech 100, ein 100 B versorgt bis zu 32 zusätzliche Sprechstellen (1x 100 M +1x 100 B = 2x16 + 2x16 =64); mit einem zweiten sind bis zu 72 Mikrofonstationen (max.) möglich (1x 100 M +1x 100 B +1x 100 B = 2x12 + 2x12 +2x12 =72); Leistungsaufnahme 72W; Abmessungen; 305x197x45mm; Gewicht: 2,45kg169,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was bedeutet Hate Speech?
Hate Speech bezeichnet beleidigende, diskriminierende oder gewalttätige Äußerungen, die aufgrund von Rasse, Religion, Geschlecht, sexueller Orientierung oder anderen persönlichen Merkmalen Hass und Feindseligkeit fördern. Es handelt sich um eine Form der verbalen Gewalt, die Menschen verletzen und ihre Rechte verletzen kann. Hate Speech ist in vielen Ländern gesetzlich verboten und wird von Online-Plattformen und sozialen Medien zunehmend bekämpft. **
-
Was ist der Unterschied zwischen einem SR- und einem RS-Glied und welche Funktion hat ein SR-Glied anhand seiner Eingänge?
Ein SR-Glied (Set-Reset-Glied) und ein RS-Glied (Reset-Set-Glied) sind zwei verschiedene Arten von Flip-Flops, die in der digitalen Schaltungstechnik verwendet werden. Der Hauptunterschied zwischen ihnen liegt in der Reihenfolge, in der die Eingangssignale angewendet werden, um den Zustand des Flip-Flops zu ändern. Ein SR-Glied hat zwei Eingänge: den Set-Eingang (S) und den Reset-Eingang (R). Je nachdem, welche Eingangssignale anliegen, kann das SR-Glied in einen von vier möglichen Zuständen wechseln: Set (Q=1, Q'=0), Reset (Q=0, Q'=1), Toggle (Q=1, Q'=1) oder Hold (Q=0, Q'=0). Die genaue **
-
Wie funktioniert Speech to Text?
Speech to Text funktioniert, indem gesprochene Wörter mithilfe von Spracherkennungssoftware in Text umgewandelt werden. Dabei werden die Audiosignale des gesprochenen Textes analysiert und in Text umgewandelt. Die Software erkennt dabei Sprachmuster, Wörter und Sätze, um sie korrekt zu transkribieren. Dieser Prozess basiert auf komplexen Algorithmen und künstlicher Intelligenz, die kontinuierlich verbessert werden, um die Genauigkeit der Umwandlung zu erhöhen. Das Ergebnis ist ein geschriebener Text, der die gesprochene Sprache möglichst genau wiedergibt. **
-
Wie verbessert Voice Recognition die Benutzererfahrung in der Technologie? Welche potenziellen Anwendungen hat Voice Recognition im Alltag?
Voice Recognition verbessert die Benutzererfahrung, indem sie die Interaktion mit Technologie vereinfacht und beschleunigt. Potenzielle Anwendungen im Alltag sind Sprachsteuerung von Smart Home-Geräten, Navigationssystemen im Auto und virtuellen Assistenten wie Siri oder Alexa. Voice Recognition kann auch in der Medizin zur Diktation von Berichten oder in der Bildung zur Verbesserung des Lernprozesses eingesetzt werden. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.